标签: DeepSeek DeepSeek-OCR 2 OCR模型 文档识别
云梦级1月27日云梦级消息,DeepSeek 今日公布了其最新一代文档识别模型 DeepSeek-OCR 2。很显然,该模型是在 DeepSeek-OCR 的基础上升级而来,核标签心变化集中在视觉编码器设计上。 研究团队提出了一种名为 DeepEncoder V2 的新型编码器结构,它能够根据图像语义动态调整视觉信息的处理顺序,使模型在进行文字识别前先对视觉内: 容进行智能排序。这项技术突破源于对传统视觉语言模型处理方式的重新思考,旨在让机器更贴近人类的视觉阅读逻辑。 在传统的视觉语言模型中,图像通常会被切分为若干视觉 token,并De按照从左上到右下的固定栅格顺序送入模型处理。这种方式虽然实现简单,但与人类在阅读文档、表格或公式时基于语义和逻辑关系进行跳跃式浏览的方式并不一致。 DeepSeek 论文指出,ep尤其在版式复杂的文档场景中,视觉元素之间往往存在明确的逻辑先后关系,仅依赖空间顺序可能限制模型对内容结构的理解能力。 DeepSeek-OCR 2 的改进重点在于引入“视觉因果流”的Se概念。在 DeepEncoder V2 中,研究团队用一种类语言模型结构替代了原先基于 CLIP 的视觉编码模块,并在编码器内部引入可学习的“因果流查询 token”。 其编码器同ek时包含双向注意力与因果注意力两种处理模式,原始视觉信息通过双向注意力进行全局感知,而新增的查询标记则通过因果注意力逐步建立语义顺序,从而在编码阶段对视觉 token 的顺序进 D行动态重排。最终,只有经过因果重排后的查询 token 会被送入后续的解码器,用于生成识别结果。 在整体架构上,DeepSeek-OCR 2 仍沿用了前代模型的编解码框架。编码器将图像ee转换为视觉标记并进行压缩,被压缩为较少数量的视觉 token,再由 DeepEncoder V2 进行语义建模和顺序重组,最后交由一个基于混合专家架构(MoE)的语言模型解码。 DeeppSSeek 论文指出,该设计在不显著增加解码负担的前提下,将单页文档所使用的视觉 token 数量控制在 256 到 1120 之间,与前代模型及同类系统的资源开销保持在相近水平。 为验证模型性ee能,研究团队在 OmniDocBench v1.5 基准上进行了全面评估。该基准涵盖多种类型的中英文文档,包括学术论文、杂志、报告等,重点考察文本识别、公式解析、表格结构还k-原以及阅读顺序等指标。 测试结果显示,在视觉 token 上限更低的情况下,DeepSeek-OCR 2 的整体得分达到 91.09%,相较 DeepSeek-OCR 提升了 3.73%OC。特别是在阅读顺序准确度方面,编辑距离从 0.085 降至 0.057,表明新模型能够更合理地理解文档内容结构。 DeepSeek-OCR 2 在生产环境中也表现出更好的稳定性。在线用户日R 志图像的重复率从 6.25% 降至 4.17%,批处理 PDF 数据的重复率从 3.69% 降至 2.88%。这些改进使得模型在保持高压缩率的同时,提升了实际应用场景中的可靠性。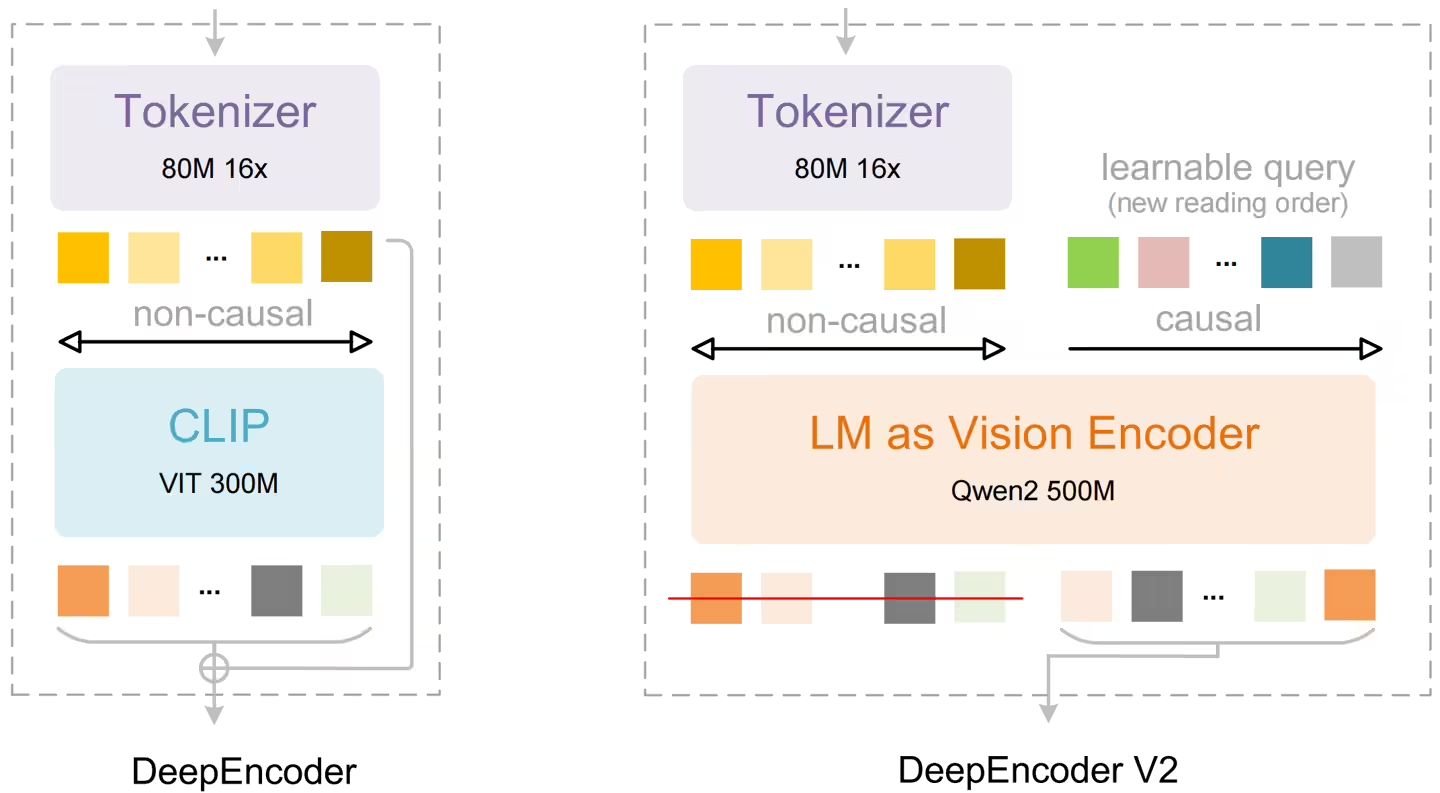
- 最近发表
- 随机阅读
-
- 标签: 抖音 AI教程 低俗内容 网络治理
- 沙漠化的原因是什么
- 可以像 Docker 一样方便的使用 Containerd 吗?
- 谷歌CEO皮查伊就AI研究员离职一事向员工道歉
- 标签: 万科 泊寓 万物云 万纬物流
- Qwen3-Omni 即将登场:端侧跨模态模型再升级,PR 已提交 Transformers 库
- 爱捷云入选“2021年度混合云优秀案例”
- 苹果发布适配版SlowFast-LLaVA模型:长视频理解性能超越大规模模型
- 2021年美国500强中最赚钱的50家公司:苹果第一,微软第二
- 英特尔押注4nm工艺,或将与台积电展开深度合作
- 标签: 阿里巴巴 千问App 蚂蚁集团 AI+云
- 谷歌收购Actifio以增强其云服务
- 标签: 魅族 魅族23 FlymeAuto 吉利
- Infosys 推出 Topaz Fabric:打造企业 IT 运营的智能化新平台
- GNN for Science: 腾讯AI Lab、清华共同发文综述等变图神经网络
- 云计算开发:Python内置函数-issubclass() 函数详解
- 标签: 宏碁 2025Q3财报 北美业务 非电脑事业
- 甲骨文与 Meta 洽谈价值 200 亿美元的云计算协议
- Rivian 再度推出新公司 Mind Robotics,聚焦工业 AI 与机器人技术
- 亚马逊 AI 技术助力 NBA 球迷将体验全新数据分析
- 搜索
-
- 友情链接